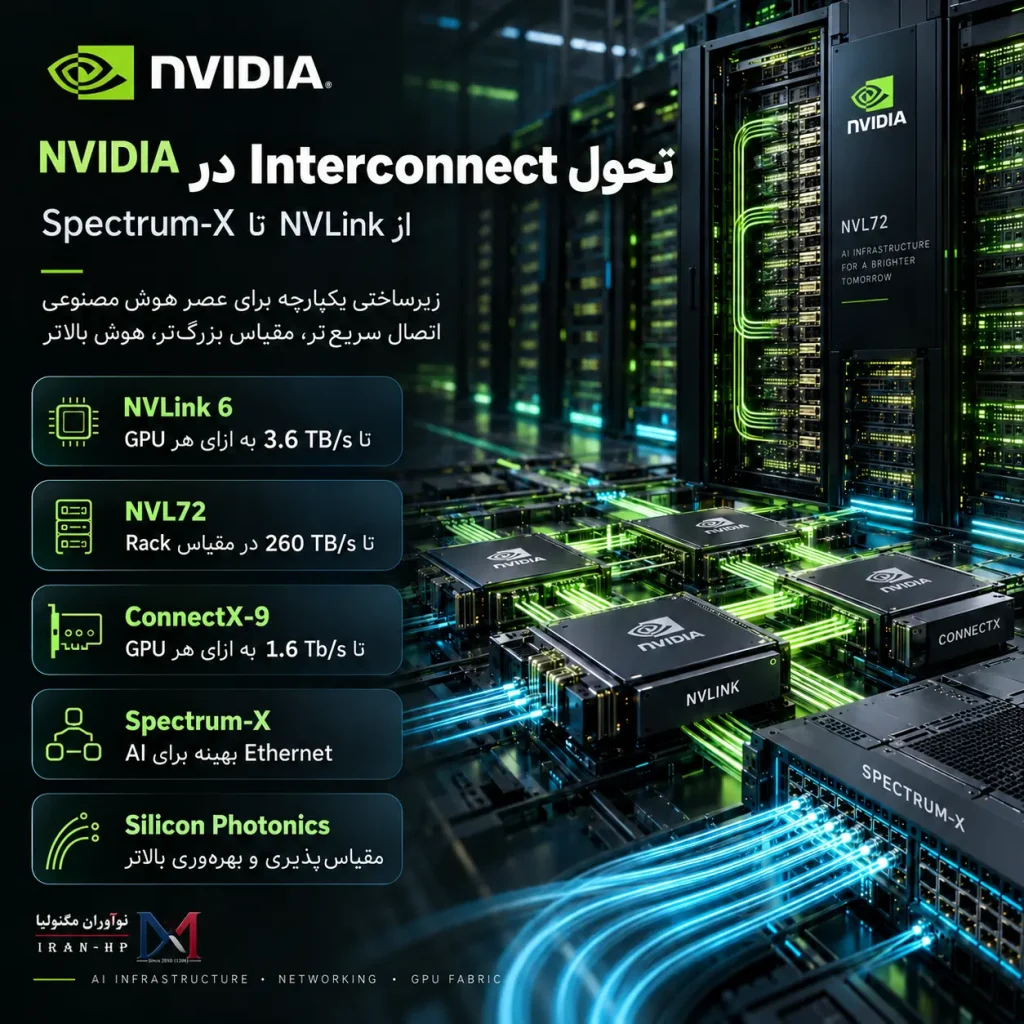
در زیرساختهای جدید AI، دیگر فقط این سؤال مهم نیست که «چه GPUای داریم؟»
یک سؤال مهمتر هم کنار آن قرار گرفته است:
داده با چه سرعتی بین GPUها جابهجا میشود؟
اگر شبکه و Fabric نتوانند همپای پردازندهها کار کنند، حتی قدرتمندترین GPUها هم بخشی از زمان خود را منتظر میمانند. این یعنی بخشی از سرمایهگذاری سختافزاری عملاً بدون استفاده کامل باقی میماند.
به نظرم همین موضوع، دلیل اصلی توجه NVIDIA به Interconnect در نسل Vera Rubin است. این شرکت فقط روی افزایش قدرت پردازش تمرکز نکرده؛ بلکه ارتباط داخل Rack و ارتباط بین Rackها را هم به بخش اصلی معماری تبدیل کرده است.
دو سطح مهم این تغییر:
- Scale-Up: ارتباط سریعتر GPUهای داخل یک Rack تا بتوانند بیشتر شبیه یک سیستم یکپارچه کار کنند.
- Scale-Out: ارتباط سریعتر بین Rackها و نودهای مختلف برای توسعه زیرساخت AI در مقیاس بزرگتر.
در NVLink 6، NVIDIA پهنایباند ارتباطی داخل Rack را نسبت به نسل Blackwell افزایش داده و در سمت شبکه هم ConnectX-9 و Spectrum-X Photonics را برای مقیاسهای بزرگتر توسعه داده است.
اما نکته مهم برای سازمانها، خودِ عدد پهنایباند نیست.
نکته مهم این است که معماری AI دارد از «چند GPU متصل به هم» به سمت «یک Fabric یکپارچه» حرکت میکند.
این تغییر برای پروژههای بزرگ AI اهمیت بیشتری دارد؛ چون مدلهای توزیعشده، Mixture-of-Experts و Agentic AI حجم زیادی از تبادل داده بین GPUها ایجاد میکنند. در چنین شرایطی، سرعت ارتباط میتواند به اندازه قدرت پردازش تعیینکننده باشد.
برای تیمهای زیرساخت، نتیجه روشن است: هنگام طراحی AI Infrastructure فقط مدل GPU را مقایسه نکنیم.
- پهنایباند و تأخیر شبکه
- ازدحام شبکه
- Scale-Up Fabric و Scale-Out Network
- برق و خنککاری
- قابلیت توسعه در آینده
همه این موارد امروز بخشی از تصمیم معماری هستند، نه جزئیات جانبی.
البته اعداد اعلامشده توسط سازنده را هم باید با احتیاط دید. نتیجه واقعی به Workload، توپولوژی، Software Stack و مقیاس استقرار بستگی دارد. به نظرم در نسل بعدی AI Factory، مزیت رقابتی فقط از «GPU قویتر» نمیآید؛ از هماهنگی بهتر Compute، Network و Fabric به دست میآید.